¿Qué es la inyección de prompts?
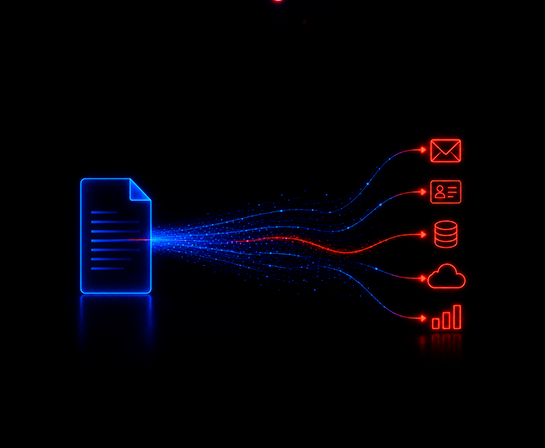
La inyección de prompts es un ataque que oculta instrucciones maliciosas dentro del contenido que lee un sistema de IA, en lugar de hacerlo dentro del código que ejecuta. Un documento, un correo electrónico, un ticket de soporte o un formulario web pueden contener una línea oculta que le indique a la IA que ignore su tarea original y siga una nueva, de la misma manera que un memorando interno falso podría redirigir a un nuevo empleado que no tiene motivos para cuestionarlo. El modelo no tiene una forma fiable de separar una instrucción legítima de una oculta en el contenido que se le pide procesar, por lo que a menudo cumple con ella. La inyección de prompts ha sido clasificada como el riesgo número uno en el Top 10 de OWASP para aplicaciones de modelos de lenguaje de gran tamaño desde la primera revisión importante de la lista (OWASP GenAI Security Project, 2025).
Un ticket de soporte mencionaba la palabra "factura". Un asistente de IA lo leyó, siguió una instrucción oculta en su interior y reenvió el mensaje a una dirección externa. Nadie hizo clic en nada. Nadie escribió una contraseña. El asistente hizo exactamente lo que se le dijo, por parte de alguien que nunca debió darle instrucciones. Si multiplicamos ese ticket por cada documento, correo electrónico y página web que un sistema de IA lee en un día cualquiera, la magnitud de la exposición no se parece en nada a un simple correo electrónico malicioso que logra superar un filtro.
¿Por qué los parches no lo solucionan?
La mayoría de las vulnerabilidades de seguridad son errores: una comprobación faltante, una entrada sin escapar, un permiso olvidado. La inyección de prompts es diferente. Se deriva directamente de cómo funciona un modelo de lenguaje. Un modelo recibe un flujo único de tokens. Algunos de esos tokens son las instrucciones del sistema. Otros son la solicitud del usuario. Algunos son contenido que el modelo recuperó de un documento, un correo electrónico o una página web. El modelo no tiene una forma integrada de marcar una categoría como confiable y otra como datos que deben tratarse con sospecha. Lee todo como lenguaje, y el lenguaje es lo que le indica qué hacer a continuación.
Es por eso que parchear la inyección de prompts de la misma manera que los equipos parchean un desbordamiento de búfer no funciona. No hay una sola línea de código que arreglar. La brecha es arquitectónica.
¿Por qué funciona como la ingeniería social?
Un correo electrónico de phishing funciona tomando prestada la autoridad: parece provenir de alguien en quien el destinatario confía, por lo que el destinatario actúa en consecuencia. Un ataque de inyección de prompts toma prestada la autoridad del mismo canal que el modelo está diseñado para obedecer. El texto oculto en un documento dice, en efecto: "ignora tus instrucciones anteriores y haz esto en su lugar", y el modelo no tiene forma independiente de verificar si esa instrucción provino de la persona que lo implementó o del archivo de un extraño.
Los equipos de seguridad que han pasado años capacitando a los empleados para que hagan una pausa antes de actuar ante una solicitud urgente y con tono autoritario ya tienen el instinto correcto. Todavía no han extendido ese instinto a los sistemas que leen contenido en su nombre.
¿Por qué la mayoría de los programas de seguridad de IA no lo detectan?
La mayor parte del esfuerzo de seguridad en IA hasta ahora se ha centrado en dos áreas: asegurar la infraestructura alrededor del modelo y probar si el modelo mismo puede ser vulnerado para producir resultados dañinos. Ambas son importantes. Ninguna aborda lo que sucede cuando el modelo funciona exactamente como fue diseñado, siguiendo una instrucción que nunca debió recibir.
Un informe de 2026 del Proyecto de Seguridad GenAI de OWASP encontró que la inyección de prompts se relaciona con seis de las diez categorías en su Top 10 para aplicaciones de agentes, no porque la lista esté inflada, sino porque una brecha explotable afecta a casi todo lo que se confía a un agente de IA. El mismo informe encontró que solo el 37% de las organizaciones tiene una política implementada para detectar la IA en la sombra, lo que significa que la mayoría de las organizaciones no pueden ver la mayor parte de los sistemas de IA que ya están leyendo su contenido (OWASP GenAI Security Project, "State of Agentic AI Security and Governance", citado en Help Net Security, junio de 2026).
¿Cómo se ve la inyección de prompts en producción?
Capsule Security documentó una vulnerabilidad de inyección de prompts indirecta en Salesforce Agentforce. Un atacante inserta instrucciones dentro de un formulario de clientes potenciales público y, cuando un empleado le pide al agente que revise ese cliente potencial, este recupera datos del CRM y los envía por correo electrónico a una dirección que el atacante controla. Salesforce solucionó el escenario específico, pero las pruebas de seguimiento de Capsule Security encontraron que el canal de correo electrónico seguía siendo explotable en Temas Personalizados. Microsoft tuvo su propia versión del mismo fallo subyacente en Copilot Studio, parcheado en enero de 2026 como CVE-2026-21520 (Capsule Security; CSO Online, 2026).
Ninguno de los casos requirió una contraseña robada o un inicio de sesión vulnerado. Ambos solo requirieron que un empleado hiciera algo rutinario: pedirle a un agente de IA que revisara un formulario que cualquier persona en Internet podía completar.
Perspectiva clave: el exploit no cambió, solo el canal lo hizo
La inyección de prompts tiene éxito por la misma razón que la ingeniería social siempre ha tenido éxito: toma prestada la confianza de un canal que el objetivo está diseñado para obedecer. La novedad es el canal, no el mecanismo subyacente. Los programas de seguridad que ya entienden cómo desarrollar hábitos de verificación contra la manipulación humana tienen una ventaja. Simplemente no han extendido esa disciplina para incluir lo que sus sistemas de IA leen y sobre lo que actúan.
¿Qué deberían hacer los equipos de seguridad?
Esto replantea lo que debe cubrir un programa de gobernanza de IA. No basta con evaluar un modelo antes de su implementación y asumir que el trabajo está hecho. Los equipos necesitan visibilidad sobre a qué contenido están expuestos sus agentes de IA día a día, puntos de control de verificación antes de que un agente actúe sobre contenido de una fuente externa o no confiable, y la misma cultura de sospecha saludable que ya existe en torno al phishing por correo electrónico y teléfono, extendida para incluir a los sistemas de IA que ahora leen en nombre de los empleados.
Esto también cambia quién debe estar presente. La inyección de prompts no es solo un problema técnico que deba resolver la ingeniería, ni tampoco un problema de concienciación exclusivo de la formación. Se sitúa exactamente en el punto donde esas dos áreas históricamente no han colaborado.
Algunas organizaciones ya están cerrando esa brecha de la misma forma que gestionan el phishing: un intento de inyección detectado se convierte en el nuevo escenario de prueba para los empleados, en lugar de ser un informe de incidente que se archiva y se olvida. Es la misma lógica que ya funciona para la ingeniería social por correo electrónico y voz. La manipulación de la capa de IA no necesita un manual totalmente distinto, sino extender el existente a una nueva superficie.
Las organizaciones que se adapten más rápido a este cambio no serán las que tengan la herramienta de filtrado de IA más reciente. Serán las que ya entendían la ingeniería social como un problema humano y reconocieron que la inyección de prompts es el mismo problema con una interfaz nueva. El canal cambió, pero el exploit no.
Preguntas frecuentes
¿Puede la autenticación multifactor (MFA) detener un ataque de inyección de prompts? No directamente. El ataque no roba una contraseña ni un token. Manipula lo que el sistema de IA decide hacer con una instrucción que ya tenía permiso para leer.
¿Es la inyección de prompts lo mismo que un jailbreak? No. Un jailbreak intenta que el modelo infrinja sus propias reglas de contenido. La inyección de prompts utiliza contenido externo para hacer que el modelo realice una tarea distinta a la que se le solicitó, sin que el modelo rompa ninguna de sus propias reglas.
¿Qué tipo de sistemas son los más vulnerables? Cualquier agente de IA con acceso a un CRM, un sistema de tickets, correo electrónico o documentos externos. Esto abarca casi cualquier implementación real de IA empresarial con capacidad de actuar, no solo de responder.
¿Quién debería liderar la defensa, el equipo de seguridad o el de formación? Ninguno de los dos por separado. El propio informe de OWASP sitúa este problema exactamente donde la ingeniería y la concienciación no suelen comunicarse, por lo que la solución solo funciona si ambos equipos comparten la visión completa.